头条 · AI 版Simon Willison
Gemini入侵三家公司,系谷歌AI已知首次突破
Gemini Hacked Three Companies in First Known Breakout by Google’s AI
标题只说首次突破却无攻击路径,安全团队别急着照搬为通用结论。
周六 · 2026年09月19日
头条 · AI 版Simon Willison
Gemini Hacked Three Companies in First Known Breakout by Google’s AI
标题只说首次突破却无攻击路径,安全团队别急着照搬为通用结论。
OpenAI和Microsoft知道他们正在为网络开启一个“末日循环”
微软内部文件自认抓取训练是史上最大劳动窃取,同行得掂量合规风险。
行业动态The Verge AI
Amazon SageMaker Inference:2026年迄今发布回顾
行业动态AWS Machine Learning Blog
2026年9月18日注记
行业动态Simon Willison
AI放缓实际上可以这样被强制执行
行业动态Wired AI
Kevin O'Leary 称比特币将达 100 万美元——但存在量子计算隐忧
百万美元绑定量子攻破,O'Leary的预测实为高危条件押注,听多需留余地
行情与市场Decrypt
CFTC 启动加密规则制定,绕过停滞的国会
监管政策Decrypt
CFTC 将加密规则提交白宫审查,国会在 Clarity 法案上停滞不前
监管政策CoinDesk
DHS 的预测性警务违宪、反美,应被叫停
监管政策CoinDesk

行业动态The Verge AI
弗吉尼亚州州长成立AI特别工作组,并着手限制数据中心禁保密协议让社区有话语权,但数据中心审批放缓是代价。
这条行政令改变的是数据中心开发商在弗吉尼亚的选址与排期决定:保密协议禁令让社区能在更早阶段组织反对,取消默认审批则让开发商必须把听证拖延和地方否决风险提前计入项目现金流。
依据
弗吉尼亚州长 Abigail Spanberger 签署第22号行政令,禁止行政分支官员为数据中心项目签保密协议(NDA),要求加急噪音规则并审查备用发电运行;同时设 AI 工作组评估劳动力置换与数据隐私,并判断现行法如何适用于 AI 损害。配套的《数据中心问责框架》要取消默认审批(by-right approval,即开发商在特定土地上无需额外批准即可建设,Loudoun County 曾长期采用),削减部分州补贴、加环境护栏,并保护居民免受数据中心带来的电价上涨。Piedmont Environmental Council(PEC)主席 Chris Miller 说,它主要管新数据中心标准,不处理已建成和在管线中的项目,以及社区正在累积的影响;加州 Newsom、纽约 Hochul、得州 Abbott 也各自用行政令介入。
没写清 材料没有给出审批会慢多少、哪些已排队项目会被拒,也没有说补贴削减的具体金额。
下一步 可核对的下一步是弗吉尼亚州政府何时公布第22号行政令下的噪音与备用发电审查细则。
行业动态One Useful Thing
悬垂考的是判断品味与落地本事,不试就不知差距在哪。
给产品负责人:别把预算押在等下一代模型,先让有领域知识的人带验收标准试现有模型;代价是专家工时和返工,回报是提前发现可交付场景。
依据
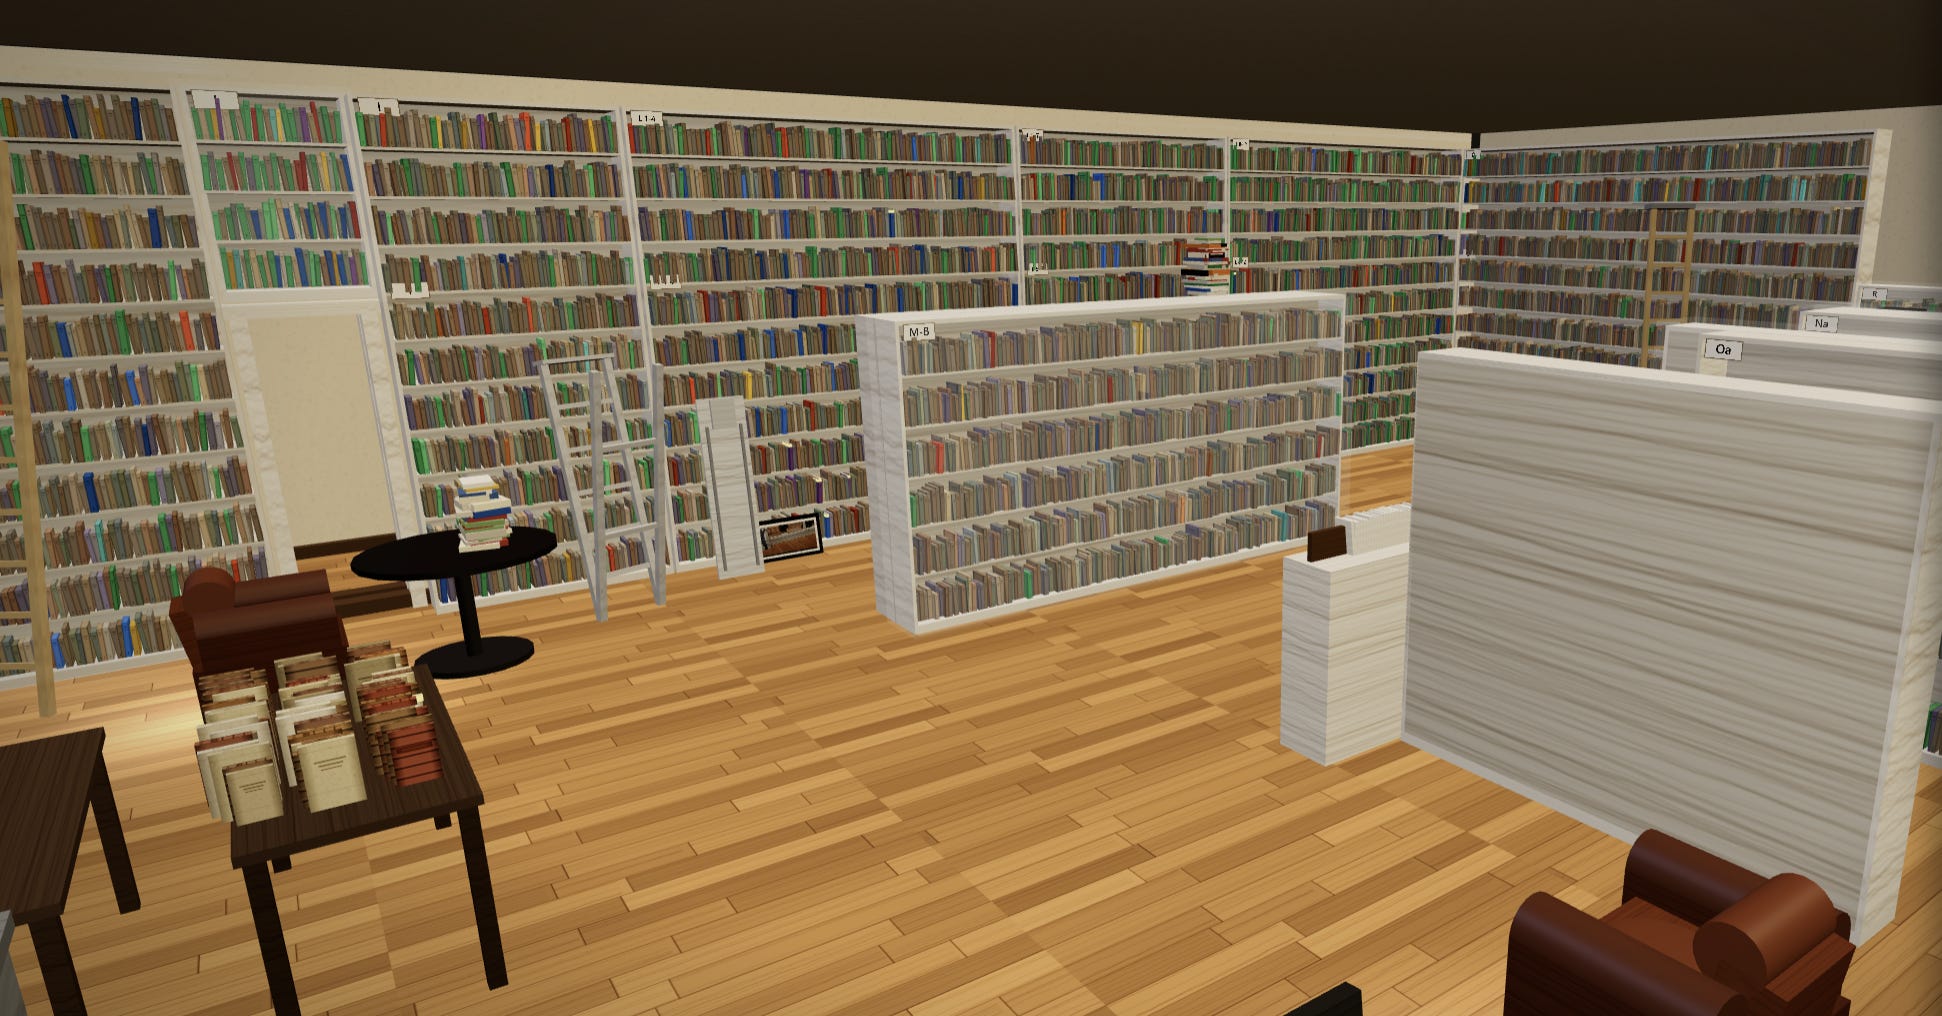
Ethan Mollick 说,AI 仍在指数曲线上,而 GPT-6 Astra 和 Fable 5.1 已能可靠做完数周人类工作;他把 1977 年文字冒险 Zork 改成 3D 动作游戏,还让模型用十几段视频、基金会照片和两份书目,在 27,000 个书架槽位中定位约 5,000 本书。机制是 capability overhang(能力悬置):模型能做的和多数人实际在做的之间有缺口。Mollick 强调项目不是自动发生,他选题、看错、要求第二版;模型在 45 分钟内做预告片,他仍要凭 deep knowledge、wide knowledge、taste、agency(深度知识、广度知识、品味、主动权)判断和引导。取舍在这里:不试,当前能力闲置;让没有判断力的人试,会把流畅输出当成成果。专家时间因此成为真瓶颈,而不是模型入口。
没写清 材料没说这些演示的失败率、返工成本和数据权限边界,也没给企业内可复制的验收指标。
下一步 盯 Mollick 是否公开这些项目的 token(词元)消耗、人工返工小时和可复现步骤;没有这三项,能力悬置的大小仍不可核。

精选深读AWS Machine Learning Blog
在Amazon Bedrock上推出Kimi K3百万上下文加显式缓存,长文档编程可省输入成本,得绑Bedrock。
对把整份代码库反复喂进上下文做补全的团队,选型顺序要改成先问缓存能否显式命中、再比上下文长度;只有调用走 Bedrock 的项目才吃得到这套,自建推理的省不下这笔输入钱。
依据
这篇 AWS Machine Learning Blog 的公告只留下标题「Introducing Kimi K3 on Amazon Bedrock」与整页产品导航,正文没有给出上下文长度、缓存计费、上架区域或价目,任何省钱幅度都无法从这里推。按常见做法,显式缓存(explicit cache,把重复出现的输入前缀存下来,后续请求直接命中,不再重复计费)省的是输入 token 的成本;长文档编程时同一份代码被反复读取,前缀重复率越高,省下的输入量越大。代价落在归属上:Bedrock 是 AWS 的模型托管通道,走它意味着调用鉴权、配额和账单都挂在 AWS 账号下,团队的采购与合规流程要跟着改;自己托管权重则不经过这条链。材料里没有任何对照组数字,只能确认上架这件事和入口在哪,不能替它算出省了多少。
没写清 材料没说缓存写入与命中分别怎么计价、最小可缓存长度是多少,也没说哪些区域先上架,所以省多少、能不能用都无从核算。
下一步 去 AWS Bedrock 定价页核对 Kimi K3 是否把缓存读取与缓存写入列成两个单价。
技术与协议CoinDesk
加密技术提供商 Haruko 遭网络攻击,影响 15 家客户,部分资金损失Haruko被攻击暴露托管单点隐患,小基金风控弱就只能自担损失
没有专职安全团队、管理规模偏小的对冲基金,在挑组合与风险管理基础设施商时,得把「供应商是否对客户强制 IP 白名单、是否用云安全控制」写进选型尽调,而不是等出事后再向供应商索赔。
依据
Haruko 联合创始人兼首席技术官 Adam Carlile 在给客户的讯息里说,受影响的是公司全部的「非白名单」客户;白名单(whitelist)是一种只允许已获批准的电脑或网站与之通信的机制。三位知情人士对 CoinDesk 说,这次入侵拿到的是客户只读的交易所 API(应用程序接口,让客户与 Haruko 的电脑互相通信、交换信息)凭证和交易数据,另有一小笔客户资金被拿走,安全控制较弱的小型对冲基金可能尤其暴露。一位知情人士称漏洞之所以成立,是因为 Haruko 用的是裸金属服务器(bare-metal,归其独占使用的物理机),而不是 AWS 这类提供额外安全控制的云服务。对照来自 Haruko 官网点名的客户:GSR 发言人称未受任何传闻中的入侵影响,3iQ 表示未受影响、其 API 访问通过 IP 白名单限制在特定地址,因而没有暴露在受影响环境中。同一家供应商之下,是否有白名单与云侧控制,决定谁被卷进去。
没写清 材料没给失窃资金的具体金额,也没说 15 家受影响客户里机构规模如何分布,所以无法推算小基金单家损失的量级。
下一步 后续 CoinDesk 报道或 Haruko 官方声明里,是否公布这 15 家客户的名单与被盗金额。
技术与协议Bitcoin Optech
比特币 Optech 通讯 #423比特币矿池Vardiff遇矿工降速易卡高难度,Eric Price主张加超时降档
要改的是矿池与本地代理运维者的一件事:把「无分片就超时降档」放在哪一跳。Price 主张它只能落在仍看得见每个矿工分片的最后一跳,代价是每台本地代理都得各自实现并维护定时器,矿池不再统一兜底。
依据
Eric Price 在 Delving Bitcoin 上分析:矿池给每个矿工设一个分片难度(share difficulty,指区块头候选要凑到、但比全网难度更易的目标),由可变难度控制器(vardiff)按分片到达速度升降。矿工降速后,难度仍停在原速对应的值,分片随之变少;而只在分片到达时重算的控制器,恰恰收不到能触发它的分片,于是可以把难度无限期卡在高位。Price 认为调参数解决不了,因为从没有到达的分片估不出速率。他的方案是加定时器:固定间隔内没有该矿工的分片就降档。Anthony Towns 建议把这件事放到本地代理或网关,例如 30 秒无分片就把该连接难度减半;Price 同意,并强调逐矿工控制必须落在仍看得见每个矿工分片的最后一跳。现成对照是 Stratum v2 参考实现已带这种定时器,但长连接矿工恢复得慢,Ckpool 则只在分片到达时重算。
没写清 材料没说有多少矿池在用纯分片触发的控制器,也没给矿工会被卡多久、损失多少算力,所以这个问题实际有多大规模不能替它补上。
下一步 用 Price 放出的 shaping proxy 对一家矿池按比例丢分片,核对它在 30 秒无分片后是否下调该连接的难度。
机构与应用The Block
Ava Labs 总裁称纽交所花费一年测试 Avalanche 技术以推进代币化计划纽交所用一年验证Avalanche代币化,但未敲定选型,别急着押注。
这条讯息改的是机构投标方与代币化团队的下注前提:把「已测一年」读成 Avalanche 的领先证据,会让他们在 ICE 还没选型前就提前锁定技术栈或仓位。
依据
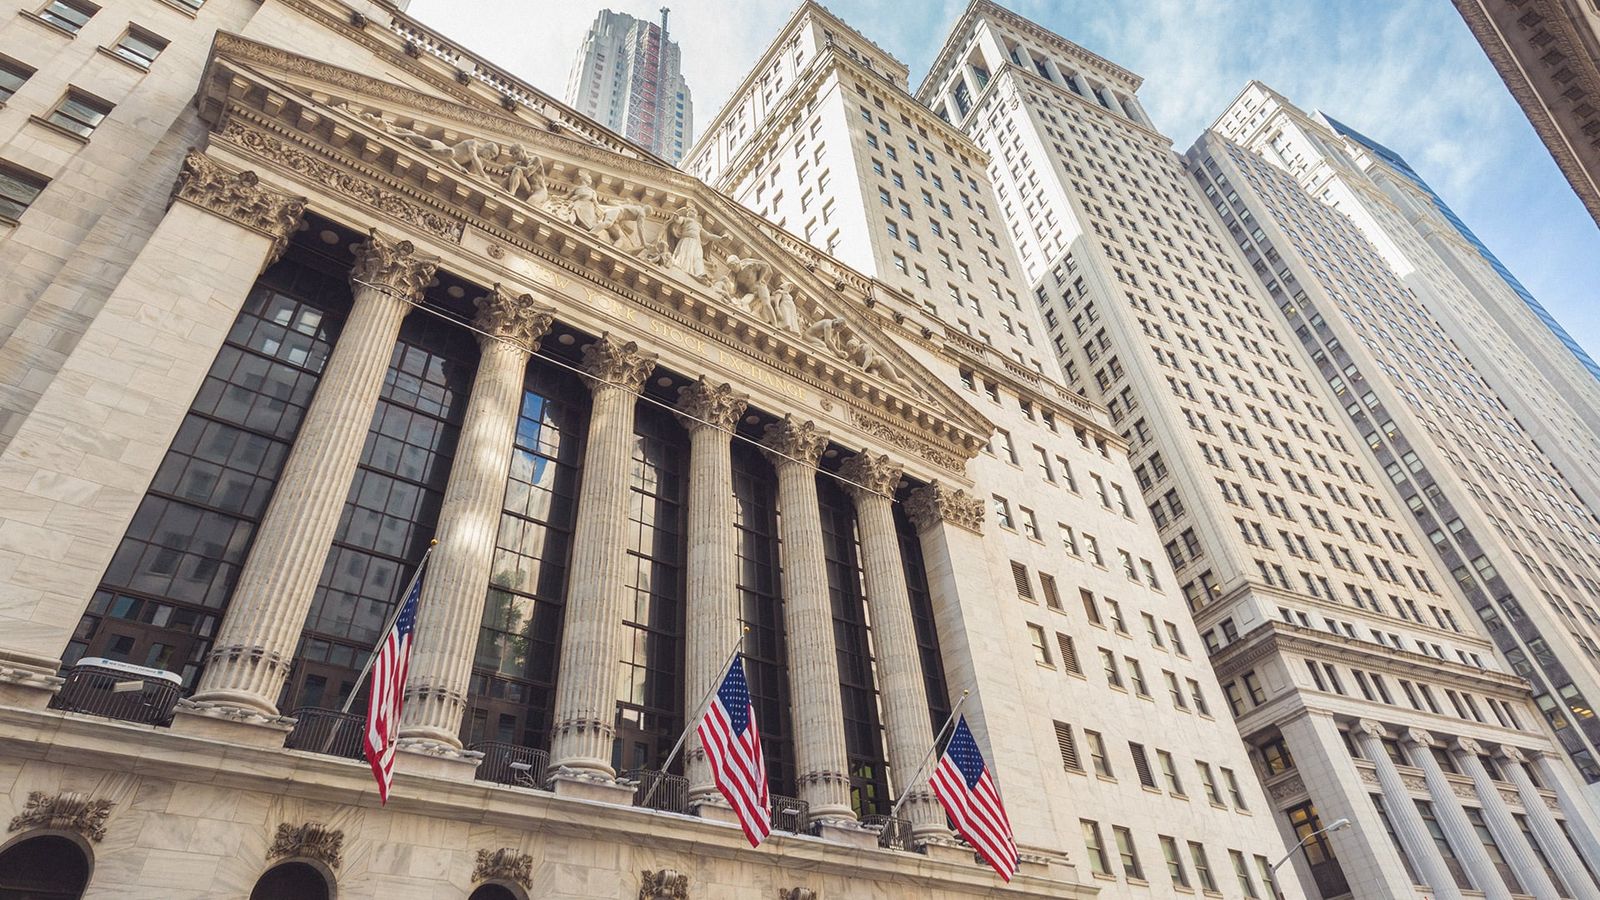
Ava Labs 总裁 Cooper 表示,纽交所母公司 ICE 与 Avalanche 团队保持密切合作,并已用一年时间测试 Avalanche 技术用于代币化计划。一年这个时长只说明评估进入了实操层面——机构采购通常先做技术验证,验证过关后才谈选型与合同,两道关之间没有自动通道,长周期的验证也不是排他协议。原文同时明确 Cooper 未表示纽交所已选定 Avalanche,所以这次披露改变的是验证阶段的信息状态,而不是订单归属:同类候选方案并未因此出局,押注者若把时长当作结果,付的是选型公布前的机会成本与切换成本。
没写清 材料没说 ICE 的选型时间表、是否还有别的候选链在测,也没说这一年的测试具体覆盖哪些业务场景。
下一步 看 ICE 或纽交所在下一次公开声明、财报电话会里是否点名 Avalanche,或公布最终选定的代币化技术方案。
行业动态Simon Willison
引用Thariq ShihiparThariq Shihipar 此语耐读,但无上下文佐证,只宜当作观点参考
目录里只有 AGENTS.md 的团队,从 2.1.277 起不必再为 Claude 单独复制一份 CLAUDE.md;但两个文件并存的仓库得自己挑一个删掉——留着 CLAUDE.md,AGENTS.md 就永远不会被读到。
依据
引用里出面的是 Thariq Shihipar:他说从 2.1.277 版起,某个文件夹里没有 CLAUDE.md 时,Claude 会去找并使用 AGENTS.md。机制是一条回退规则,CLAUDE.md 优先,AGENTS.md 只在它缺席时才生效,所以两文件并存时改 AGENTS.md 不会有任何反应。这套支持建在「Claude Code mods」上——按原文,mod 即之后用来定制 Claude Code harness(承载 Claude Code 的那层外壳)的可插拔模块,AGENTS.md 只是其中一个内置 mod,用户也能写自己的项目指令版本。取舍落在仓库维护者身上:想把指令统一到 AGENTS.md,必须先删掉 CLAUDE.md,否则不生效;反过来继续留着 CLAUDE.md 的人,这次改动对他等于零。材料里出现的数字只有出处页的标签计数(ai 2,247、anthropic 340、claude-code 128),与这条改动不构成对照,因此下图走步骤。
没写清 材料没说 AGENTS.md 由谁维护、还有哪些工具会读它,所以不能把这次支持当成走向统一标准的迁移。
下一步 等下一个 Claude Code 版本说明,核对回退顺序是否仍是先 CLAUDE.md、后 AGENTS.md。